Cụm máy chủ sẵn sàng cao (HA): quorum, mạng, diễn tập rút nguồn
Tác giả
Nguyen Huu Cuong
Ngày đăng

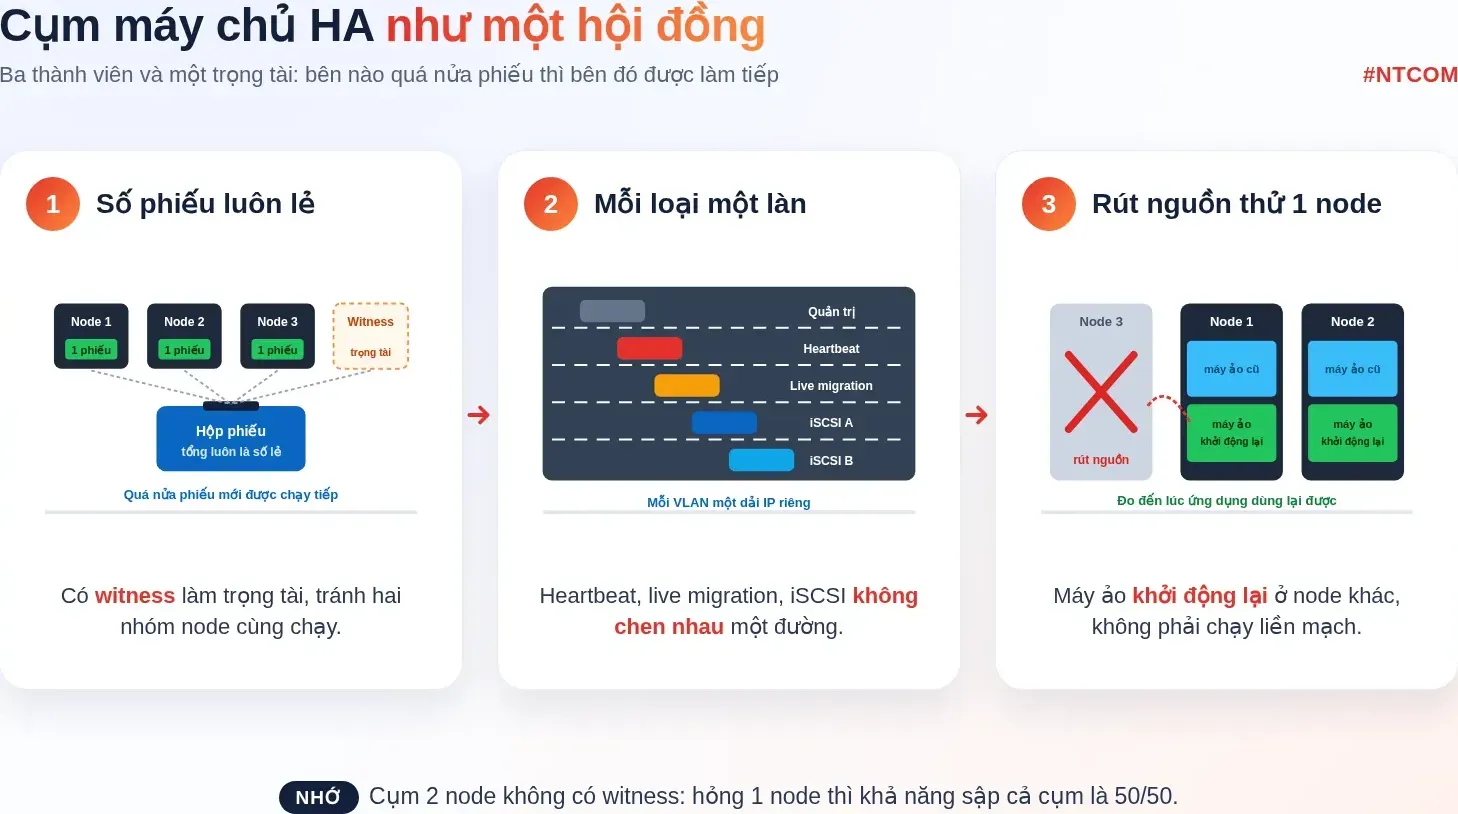
Một cụm máy chủ sẵn sàng cao (HA) chỉ thật sự "sẵn sàng" khi đủ ba thứ: số phiếu quorum luôn lẻ để cụm biết bên nào được sống, lưu trữ dùng chung có hai đường đi, và mạng heartbeat, live migration, iSCSI tách VLAN riêng thay vì dồn chung một đường. Thiếu một trong ba thì cụm vẫn chạy bình thường hằng ngày, chỉ đến hôm mất điện một node mới lộ ra. Bài này kể lại một cụm Hyper-V hai node đã sập cả cụm chỉ vì một node mất nguồn, cách anh em kỹ thuật NTCOM làm lại, và buổi diễn tập rút nguồn mà chúng tôi bắt buộc làm trước khi ký biên bản nghiệm thu.
Hiểu nhanh bằng hình
Hiện trạng: cụm hai node, sập cả hai khi hỏng một
Khách hàng là một bệnh viện tuyến tỉnh ở miền Trung. Phần mềm quản lý bệnh viện (HIS), phần mềm xét nghiệm, AD, file server và kế toán chạy trên một cụm Hyper-V hai node do đơn vị khác dựng từ vài năm trước, nối chung một bộ lưu trữ iSCSI. Trên giấy, đây là hệ "dự phòng": một máy hỏng thì máy kia gánh.
Một buổi chiều, thanh PDU cấp nguồn cho node 1 bị nhảy aptomat. Node 1 tắt ngay. Chuyện đáng lẽ chỉ làm các máy ảo trên node 1 khởi động lại trên node 2, nhưng thực tế cả cụm dừng, HIS ngừng gần một tiếng, khoa khám bệnh phải ghi tay. Anh IT gọi chúng tôi lúc node 1 đã có điện lại nhưng cụm vẫn chưa lên hết.
Đọc nhật ký cụm, nguyên nhân hiện ra khá nhanh, và có ba lỗi cộng dồn:
- Không có witness. Cụm hai node không có phiếu thứ ba. Node chết lại đúng là node đang giữ phiếu, node còn lại không đủ đa số nên tự dừng dịch vụ cụm.
- Mạng dồn một chỗ. Mỗi node có hai cổng 1G gộp thành một team, chở cả quản trị, heartbeat, live migration và người dùng truy cập. Mỗi lần live migration một máy ảo lớn, đường mạng đầy, đã từng có lần cụm báo mất liên lạc với node đang chuyển.
- iSCSI một đường. Lưu trữ chỉ có một switch ở giữa. Switch đó khởi động lại là cả hai node cùng mất đĩa.
Quorum: vì sao cụm hai node không có witness là canh bạc
Quorum là cơ chế bỏ phiếu để tránh "hai não" (split-brain): khi mạng giữa các node bị cắt, mỗi nhóm node đều tưởng mình là cụm và cùng ghi lên một ổ đĩa, dữ liệu máy ảo hỏng. Microsoft giải thích cụm cần quá nửa số phiếu để tiếp tục chạy, nhóm nào không đủ đa số thì tự dừng. Cụm Windows Server các bản hiện nay có dynamic quorum và dynamic witness: tự bật, tắt phiếu của node và witness để tổng số phiếu luôn lẻ.
Với cụm hai node không có witness, cụm tự bỏ phiếu của một node để tổng thành 1. Node không có phiếu chết thì cụm sống; node có phiếu chết đột ngột thì cụm sập. Microsoft ghi thẳng khả năng sống sót khi hỏng một node của trường hợp này là 50/50. Bệnh viện này rơi đúng vào nửa xấu. Bảng dưới tóm theo tài liệu "Understand cluster and pool quorum" của Microsoft:
Số node | Hỏng 1 node | Hỏng 1 node, sau đó thêm 1 node | Hỏng 2 node cùng lúc |
|---|---|---|---|
2 | 50/50 | Không | Không |
2 + witness | Có | Không | Không |
3 | Có | 50/50 | Không |
3 + witness | Có | Có | Không |
4 | Có | Có | 50/50 |
4 + witness | Có | Có | Có |
Khuyến nghị của Microsoft: hai node thì bắt buộc có witness, ba hoặc bốn node thì rất nên có, từ năm node trở lên thì witness không thêm khả năng chịu lỗi. Có ba loại witness:
- Disk witness: một LUN nhỏ trên lưu trữ dùng chung, lớn hơn 512 MB, basic disk, không gán ký tự ổ, không chứa dữ liệu khác. Không dùng ổ CSV làm witness.
- File share witness: một thư mục chia sẻ SMB 2 trở lên, trống tối thiểu 5 MB, dành riêng cho một cụm. Microsoft khuyên đặt tách khỏi các node về mạng, nguồn, tủ rack, thậm chí phòng. Không dùng DFS hay thư mục được nhân bản làm witness.
- Cloud witness: dùng tài khoản Azure Storage, các node cần ra được Internet qua cổng 443.
Bệnh viện không muốn phụ thuộc Internet cho phần lõi, nên chúng tôi chọn file share witness đặt trên một NAS nhỏ ở phòng mạng tầng khác, cắm nguồn từ UPS khác với tủ máy chủ. Đặt witness trên chính bộ lưu trữ của cụm hoặc trên một máy ảo chạy trong cụm là cách làm hay gặp và sai: hỏng tủ là mất luôn phiếu thứ ba.
# Xem cấu hình quorum hiện tại và phiếu của từng nodeGet-ClusterQuorumGet-ClusterNode | Format-Table Name, State, NodeWeight, DynamicWeight(Get-Cluster).WitnessDynamicWeight# Đặt file share witness (thư mục trên NAS ở phòng khác, chỉ cấp quyền cho tài khoản máy của cụm)Set-ClusterQuorum -NodeAndFileShareMajority \\NAS-P2\witness-cl01
Thiết kế lại: ba node, lưu trữ hai đường, mạng tách làn
Ngân sách năm đó đủ cho một node mới và nâng mạng lên 10G/25G. Cụm mới gồm ba node Dell PowerEdge R760xs, lưu trữ Infortrend EonStor GS 3012R3 loại hai controller dự phòng, và hai switch Cisco Catalyst C9300-48S-A xếp chồng. Cách tính tài nguyên sao cho mất một node vẫn đủ chạy, chúng tôi đã viết ở bài gom 10 máy chủ vật lý lên cụm ảo hoá 3 node; ở đây chỉ nói phần làm cho cụm chịu được lỗi.
Lưu trữ dùng chung
- Mỗi node có hai cổng dành riêng cho iSCSI, một cổng sang switch A, một cổng sang switch B, mỗi đường một VLAN và một dải IP. Bật MPIO trên Windows. Microsoft yêu cầu card nối iSCSI chỉ dùng cho iSCSI, không chở thêm loại lưu lượng khác, và card giữa các node nên giống nhau.
- Mỗi controller của bộ lưu trữ cũng có cổng nối cả hai switch. Rút một switch, một controller hay một sợi cáp thì máy ảo vẫn còn đường tới đĩa.
- LUN cho máy ảo đưa vào Cluster Shared Volume (CSV), định dạng NTFS. Tài liệu Microsoft ghi: ổ SAN nên định dạng NTFS trước khi thêm vào CSV; định dạng ReFS trên SAN thì CSV chạy ở chế độ chuyển hướng I/O qua node điều phối, chậm hơn. Đây là lỗi chúng tôi gặp ở vài cụm khác, người dựng chọn ReFS vì "mới hơn".
- LUN của cụm này chỉ cấp cho ba node của cụm (LUN masking trên bộ lưu trữ), máy chủ khác không nhìn thấy.
Mạng: mỗi loại lưu lượng một VLAN, một dải IP
Microsoft liệt kê các loại lưu lượng của cụm Hyper-V gồm quản trị, cụm (heartbeat và chuyển hướng CSV), live migration, lưu trữ, nhân bản và truy cập máy ảo, kèm khuyến nghị cách đặt cho từng mạng. Hai điểm hay bị bỏ qua: live migration không mã hoá và có thể chiếm hết băng thông đường truyền, nên phải nằm VLAN riêng; và cụm chỉ nhận một địa chỉ IP trên mỗi subnet của mỗi node, nên muốn tách mạng thì mỗi VLAN phải là một subnet riêng. Bảng dưới là phương án của bệnh viện (số VLAN là ví dụ):
Mạng | VLAN (ví dụ) | Đường vật lý | Role trong cụm | Ghi chú |
|---|---|---|---|---|
Quản trị | 10 | Team 2 x 25G qua hai switch | 3: cụm và client | AD, DNS, WSUS, quản trị host |
Cụm, heartbeat | 20 | Team 2 x 25G qua hai switch | 1: chỉ cụm | Heartbeat, chuyển hướng CSV |
Live migration | 30 | Team 2 x 25G qua hai switch | 1: chỉ cụm | Chỉ cho live migration chạy ở mạng này |
iSCSI A | 40 | 1 cổng 25G riêng sang switch A | 0: không dùng cho cụm | MPIO đường 1 |
iSCSI B | 41 | 1 cổng 25G riêng sang switch B | 0: không dùng cho cụm | MPIO đường 2 |
Máy ảo | 100 trở lên | Switch ảo trên team | Không hiện trong cụm | Theo từng khoa, phòng |
Role 0, 1, 3 là giá trị của thuộc tính Role trong cụm theo tài liệu Microsoft: 0 không cho cụm dùng, 1 chỉ cho liên lạc nội bộ cụm, 3 cho cả cụm và client. Mặc định cụm tự đoán, và nó hay đoán mạng iSCSI là mạng cụm, thế là heartbeat chạy lẫn với lưu lượng đĩa. Chúng tôi đổi tên mạng cho dễ đọc rồi đặt lại bằng lệnh:
# Xem các mạng cụm tự nhậnGet-ClusterNetwork | Format-Table Name, Role, Address# Đặt vai trò từng mạng (đổi tên trước cho dễ nhận)(Get-ClusterNetwork -Name "Cluster Network 1").Name = "Quan tri"(Get-ClusterNetwork -Name "Quan tri").Role = 3(Get-ClusterNetwork -Name "Heartbeat").Role = 1(Get-ClusterNetwork -Name "LiveMigration").Role = 1(Get-ClusterNetwork -Name "iSCSI-A").Role = 0(Get-ClusterNetwork -Name "iSCSI-B").Role = 0# Chỉ cho live migration chạy trên mạng LiveMigration, loại trừ mọi mạng khácGet-ClusterResourceType -Name "Virtual Machine" |Set-ClusterParameter -Name MigrationExcludeNetworks -Value ([String]::Join(";", (Get-ClusterNetwork | Where-Object {$_.Name -ne "LiveMigration"}).ID))
Trên switch, hai VLAN iSCSI không có cổng định tuyến và không đi lên lõi. VLAN heartbeat và live migration cũng chỉ nằm trong cặp switch của phòng máy. Một câu khách hay hỏi: "có cần card riêng cho heartbeat không". Không bắt buộc. Điều Microsoft nhấn mạnh là không để điểm hỏng đơn trên đường nối các node; heartbeat đi VLAN riêng trên team hai cổng qua hai switch là đủ cho cụm cỡ này.
Diễn tập: rút nguồn một node trước khi ký nghiệm thu
Trước khi dựng cụm, chúng tôi chạy Test-Cluster và lưu báo cáo. Microsoft chỉ hỗ trợ cụm khi toàn bộ cấu hình qua được các bài kiểm tra này. Nhưng báo cáo xanh chỉ chứng minh cấu hình đúng trên giấy. Câu hỏi thật của bệnh viện là "rút điện một máy thì HIS mất bao lâu", và câu đó chỉ trả lời được bằng diễn tập.
Buổi diễn tập làm vào sáng chủ nhật, có mặt IT bệnh viện, một người bên phần mềm HIS và đại diện phòng vật tư. Bốn kịch bản, làm từ nhẹ đến nặng:
Kịch bản | Thao tác | Kỳ vọng | Kết quả đo được (ví dụ của case) |
|---|---|---|---|
1. Bảo trì có kế hoạch | Drain node 2 bằng lệnh, máy ảo live migration sang node khác | Người dùng không thấy gián đoạn | 11 máy ảo chuyển xong trong khoảng 3 phút, phiên HIS không rớt |
2. Rút một cáp iSCSI | Rút cáp iSCSI A trên node 1 | MPIO chuyển sang đường B, máy ảo chạy tiếp | Máy ảo chạy tiếp, nhật ký MPIO ghi mất một đường |
3. Tắt switch A | Tắt nguồn switch A | Team và MPIO chuyển sang switch B, không node nào bị đẩy khỏi cụm | Máy ảo chạy tiếp, ping từ máy trạm mất vài gói |
4. Rút nguồn một node | Rút cả hai dây nguồn node 3 đang chạy HIS | Máy ảo của node 3 khởi động lại trên node 1 và 2 | HIS dùng lại được sau khoảng 6 phút, chủ yếu là thời gian máy ảo khởi động và dịch vụ ứng dụng lên |
Kịch bản 4 là chỗ cần nói rõ với khách: HA không phải "không gián đoạn". Live migration chỉ dùng khi chủ động chuyển (bảo trì, vá lỗi). Khi node chết đột ngột, bộ nhớ của máy ảo trên node đó mất theo, cụm chỉ khởi động lại máy ảo ở node khác, giống như bấm nút nguồn. Ứng dụng nào cần không gián đoạn hẳn thì phải có cơ chế ở tầng ứng dụng (hai máy chủ cơ sở dữ liệu đồng bộ, hai máy AD), chứ không trông vào HA của tầng ảo hoá.
Kịch bản 3 cũng có một điểm cần biết: từ Windows Server 2016, cụm không đẩy máy ảo đi ngay khi một node mất liên lạc ngắn, mà chờ một khoảng thời gian chịu lỗi (thuộc tính ResiliencyDefaultPeriod, mặc định 240 giây theo tài liệu Microsoft) để tránh khởi động lại máy ảo hàng loạt chỉ vì switch khởi động lại. Ai diễn tập bằng cách rút cáp mạng rồi đứng chờ máy ảo chuyển ngay sẽ tưởng cụm hỏng. Chúng tôi giữ giá trị mặc định này.
Các lệnh dùng trong buổi diễn tập:
# Kịch bản 1: rút máy ảo khỏi node 2 để bảo trì, xong thì đưa vềSuspend-ClusterNode -Name HV02 -DrainGet-ClusterGroup | Format-Table Name, OwnerNode, StateResume-ClusterNode -Name HV02 -Failback Immediate# Sau mỗi kịch bản: xem node, máy ảo và lấy log cụm 30 phút gần nhất làm hồ sơGet-ClusterNode | Format-Table Name, StateGet-ClusterGroup | Where-Object State -ne "Online"Get-ClusterLog -Destination C:\DienTap -TimeSpan 30
Diễn tập lần đầu không suôn sẻ. Kịch bản 4, máy ảo HIS lên trên node 1 nhưng dịch vụ ứng dụng không chạy vì nó khởi động trước máy ảo cơ sở dữ liệu. Chúng tôi đặt độ ưu tiên khởi động (máy ảo AD và cơ sở dữ liệu ưu tiên cao, ứng dụng trung bình, máy phụ thấp), đặt hai máy AD không nằm chung node, rồi làm lại kịch bản 4 lần nữa mới ký biên bản.
Kết quả và bài học
Sau nửa năm, cụm qua thêm hai lần sự cố thật: một lần switch A khởi động lại do lỗi phần mềm, một lần node 2 báo lỗi RAM và được drain ra để thay trong giờ hành chính. Cả hai lần người dùng không biết. Mỗi tháng IT bệnh viện vá lỗi từng node bằng cách drain, không còn phải xin dừng HIS lúc nửa đêm.
Bài học chúng tôi rút ra:
- Đếm phiếu trước khi đếm máy. Cụm chẵn node phải có witness, và witness đặt ở chỗ không chết cùng với tủ máy chủ.
- Vẽ đường đi của từng loại lưu lượng ra giấy, mỗi đường hỏi "rút sợi này thì sao". Chỗ nào chỉ có một đường là chỗ sẽ sập.
- Diễn tập rút nguồn là phần bắt buộc của nghiệm thu, và đo bằng đồng hồ thời gian ứng dụng dùng lại được, không phải thời gian máy ảo "Online".
- Nói rõ với chủ đầu tư HA khác không gián đoạn, để ứng dụng quan trọng có thêm dự phòng ở tầng ứng dụng.
Nền tảng khác như Proxmox VE hay VMware vSphere có cơ chế HA với tên gọi và cách cấu hình riêng, nhưng ba nguyên tắc trên vẫn giữ nguyên. So sánh các nền tảng ở bài chọn nền tảng ảo hoá Hyper-V, VMware hay Proxmox. HA cũng không thay được sao lưu: máy ảo bị xoá nhầm hay bị mã hoá thì cả ba node cùng thấy bản hỏng, xem thêm bài sao lưu và phục hồi Hyper-V bằng Windows Server Backup.
Ghi yêu cầu cụm HA trong hồ sơ mời thầu
Cách ghi yêu cầu
- Ghi yêu cầu theo khả năng chịu lỗi: "khi một node bất kỳ ngừng hoạt động, các máy ảo tự khởi động lại trên các node còn lại; cụm có witness đặt tách khỏi tủ máy chủ".
- Lưu trữ dùng chung có hai controller dự phòng, mỗi node có tối thiểu hai đường kết nối lưu trữ qua hai switch khác nhau, có MPIO.
- Mạng tách riêng quản trị, heartbeat, live migration, lưu trữ và máy ảo theo VLAN, không có điểm hỏng đơn giữa các node.
- Nghiệm thu gồm báo cáo kiểm tra cụm (cluster validation) đạt và biên bản diễn tập tối thiểu: drain một node, rút một đường lưu trữ, tắt một switch, rút nguồn một node, có ghi thời gian ứng dụng dùng lại được.
Cách điền đáp ứng
- Đính kèm sơ đồ đấu nối và bảng VLAN như bảng trên, chỉ rõ mỗi cổng của node và bộ lưu trữ cắm vào switch nào.
- Ghi loại witness và vị trí đặt, trích dẫn tài liệu quorum của Microsoft làm căn cứ cho số node và witness.
- Thông số controller kép, số cổng của bộ lưu trữ và máy chủ đối chiếu với datasheet chính hãng, ghi số trang.
- Nộp kịch bản diễn tập kèm tiêu chí đạt, để chủ đầu tư dùng chính tài liệu đó khi nghiệm thu.
Xem thêm máy chủ, lưu trữ và switch cho cụm ảo hoá tại danh mục Giải pháp ảo hoá máy chủ, danh mục SAN, NAS và các bài cùng chủ đề trong chuyên mục Ảo hoá máy chủ, Trung tâm dữ liệu. Giá: liên hệ báo giá.
Nhận hỗ trợ hồ sơ thầu trong 24 giờ
Gửi cho NTCOM thông tin gói thầu kèm Phạm vi cung cấp (PVCC), datasheet, bảng thông số hoặc bảng điền đáp ứng. NTCOM tra mã sản phẩm, hãng sản xuất và điền đáp ứng kỹ thuật, phản hồi trong vòng 24 giờ. Báo giá ngay sau khi có đầy đủ hồ sơ, tên dự án, tên EU.
- Hotline: 0986 397 886
- Zalo: 0986397886
- Email: nguyen.cuong@ntcomvn.com
Nguồn tham khảo
- Microsoft Learn: Understand cluster and pool quorum
- Microsoft Learn: Deploy a quorum witness for a failover cluster
- Microsoft Learn: Network recommendations for Hyper-V in a failover cluster
- Microsoft Learn: Failover clustering hardware requirements and storage options
- Microsoft Learn: Use Cluster Shared Volumes in a failover cluster
- Microsoft Learn: Create a failover cluster
- Microsoft Learn: ResiliencyDefaultPeriod
- Microsoft Learn: Set-ClusterQuorum, Suspend-ClusterNode, Get-ClusterLog
- Infortrend: EonStor GS 3000 family
Tài liệu mang tính tham khảo kỹ thuật; số liệu case (thời gian chuyển, số VLAN, số máy ảo) là ví dụ của một dự án, cần đối chiếu tài liệu chính thức của hãng và thử nghiệm trên hệ thống thật trước khi lập hồ sơ.
Bình luận(0)
Chưa có bình luận. Hãy là người đầu tiên chia sẻ ý kiến!